DOWNLOADS
ダウンロード
ウイグル語を書くため、画像の中の文字を読み取るための無料の Windows 用プログラムです。
UyghurEdit++
主な機能
- スペルチェック:綴りの誤った語に赤い下線を引いて示し続けます。
- 文字の変換:アラビア文字・ラテン文字・キリル文字のあいだで書き換えます。
- スペルチェックの辞書は、2009年刊の正書法辞典『Hazirqi Zaman Uyghur Edebiy Tilining Imla Lughiti』の語幹を活用させて作られ、約44万1千語を収めています。
- ラテン文字入力モード(Ctrl+K で切り替え)。
- 編集中の文書から HTML を作成。
画像の中の文字の読み取り(OCR)には UyghurOCR を使ってください。
0.84 の変更点
- OCR(画像の中の文字の読み取り)は、別のプログラム UyghurOCR に移りました。
- ダウンロードが約 68 MB から約 5 MB に小さくなりました。
- Microsoft Visual C++ 再頒布可能パッケージは不要になりました。
画面
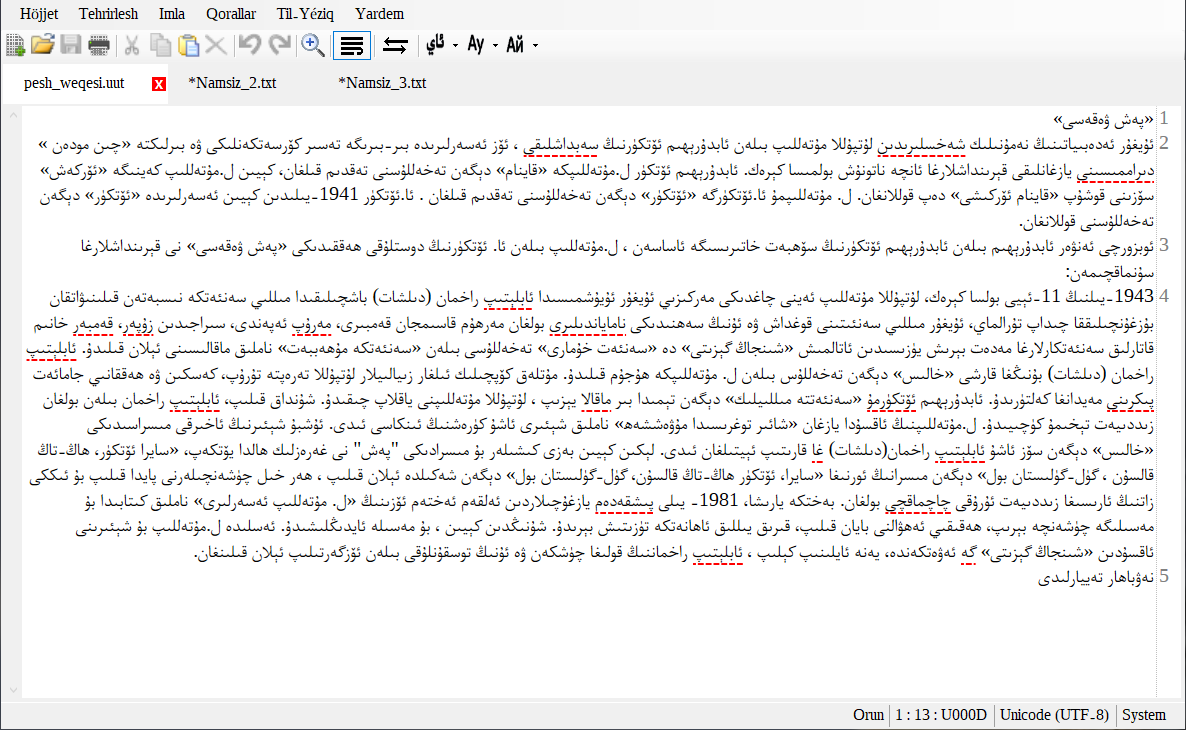
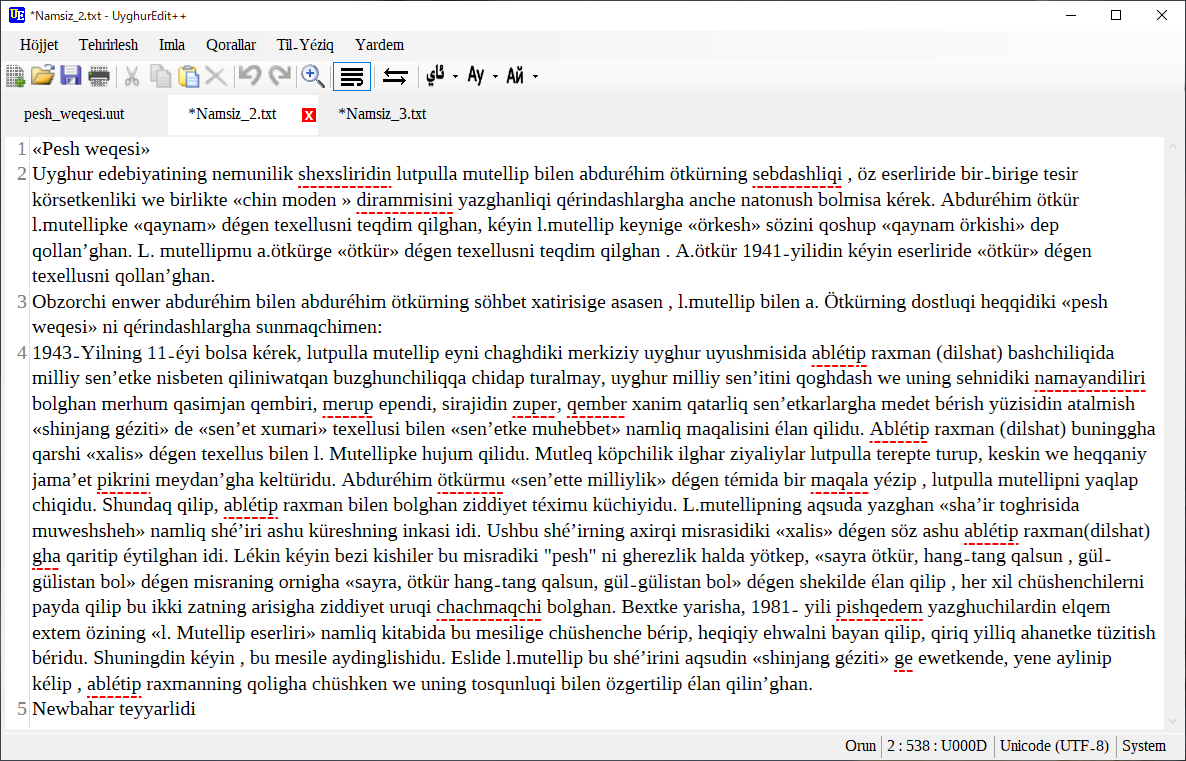
ライセンスとソースコード
UyghurEdit++ はオープンソースのソフトウェアで、MIT ライセンスで公開されています。ソースコードを取得して自分でビルドして使うこともできます。
GitHub のリポジトリMIT ライセンスの全文UyghurEdit++ のプライバシーポリシー
このページの画面写真とアイコンは、同じリポジトリのものを MIT ライセンスのもとで掲載しています。
UyghurOCR
画像や PDF の中の文字を読み取って、テキストにする無料のプログラムです。
主な機能
- 読み取れる言語:ウイグル語・英語・トルコ語・中国語(簡体字)・ロシア語。いくつかを同時に選べます。
- 画像・PDF のほか、フォルダーの中のファイルをまとめて読み取れます。ドラッグ&ドロップやクリップボードの画像にも対応しています。
- 画面上で範囲を選んで、その部分だけを読み取れます。
2.0 の変更点
- PDF を直接開けるようになり、ウイグル語の読み取りの精度が上がりました(一部の手書きも読めます)。