—UYGHUR TEXT EDITOR—
UyghurEdit++
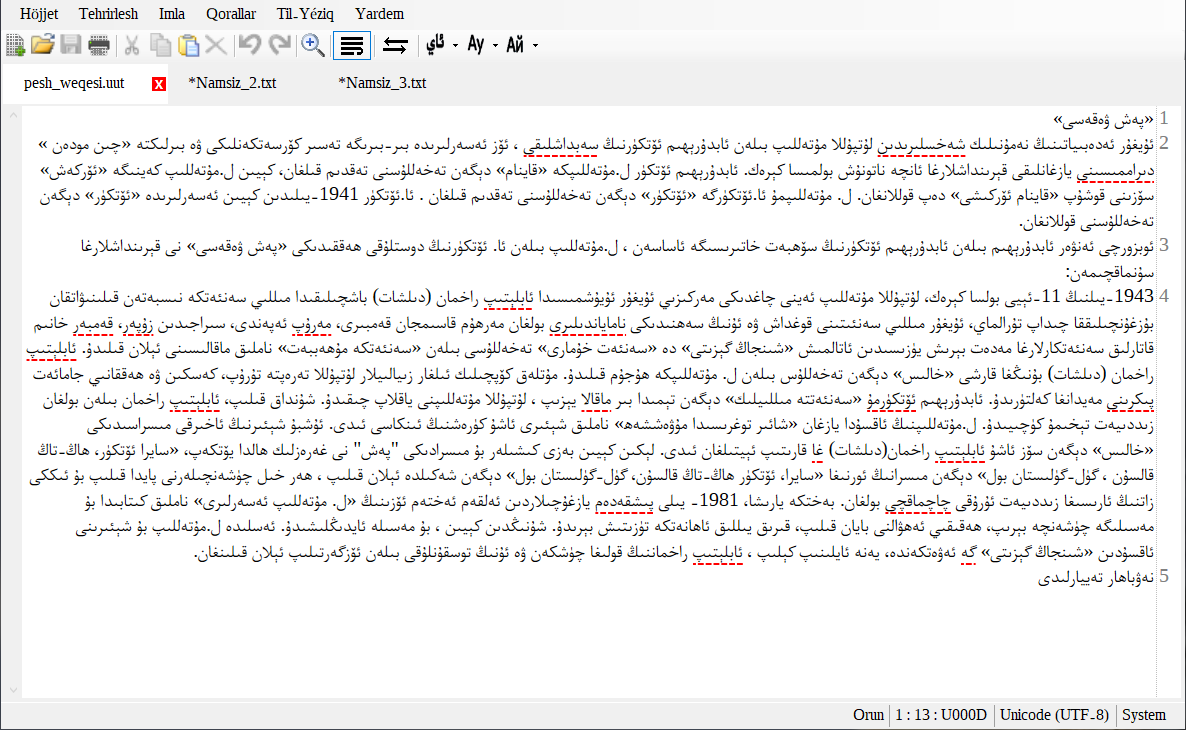
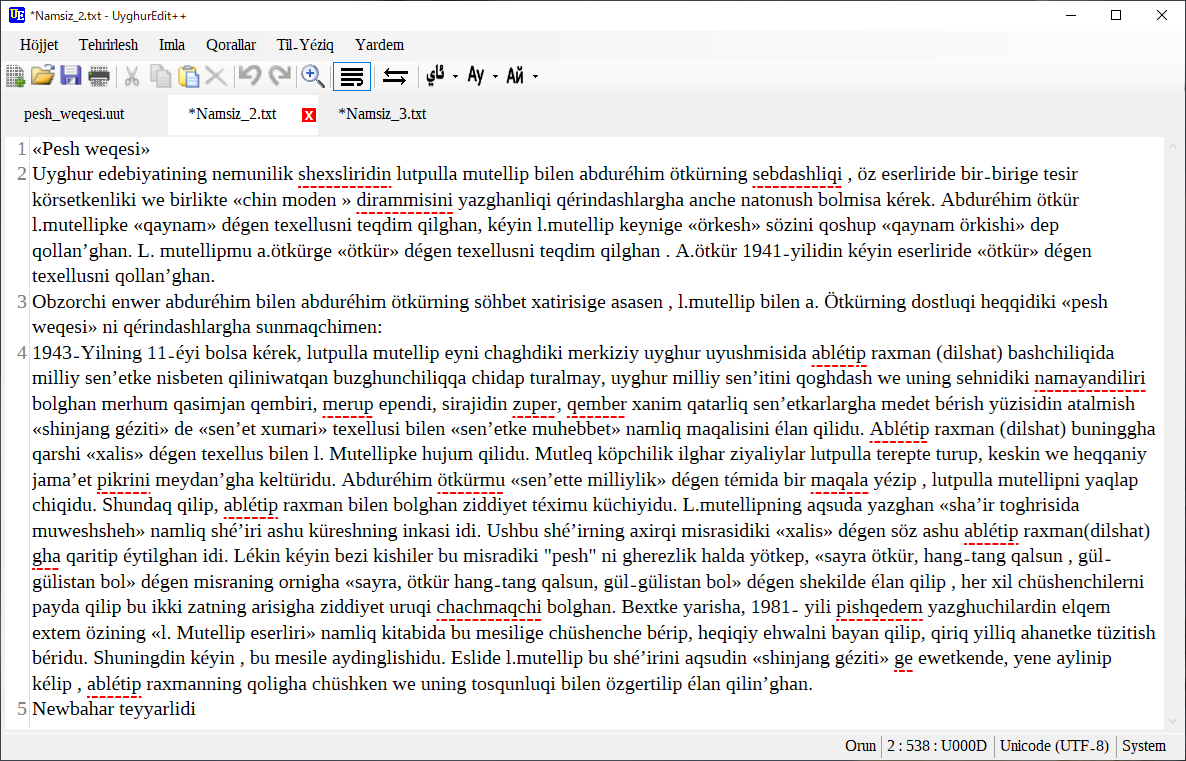
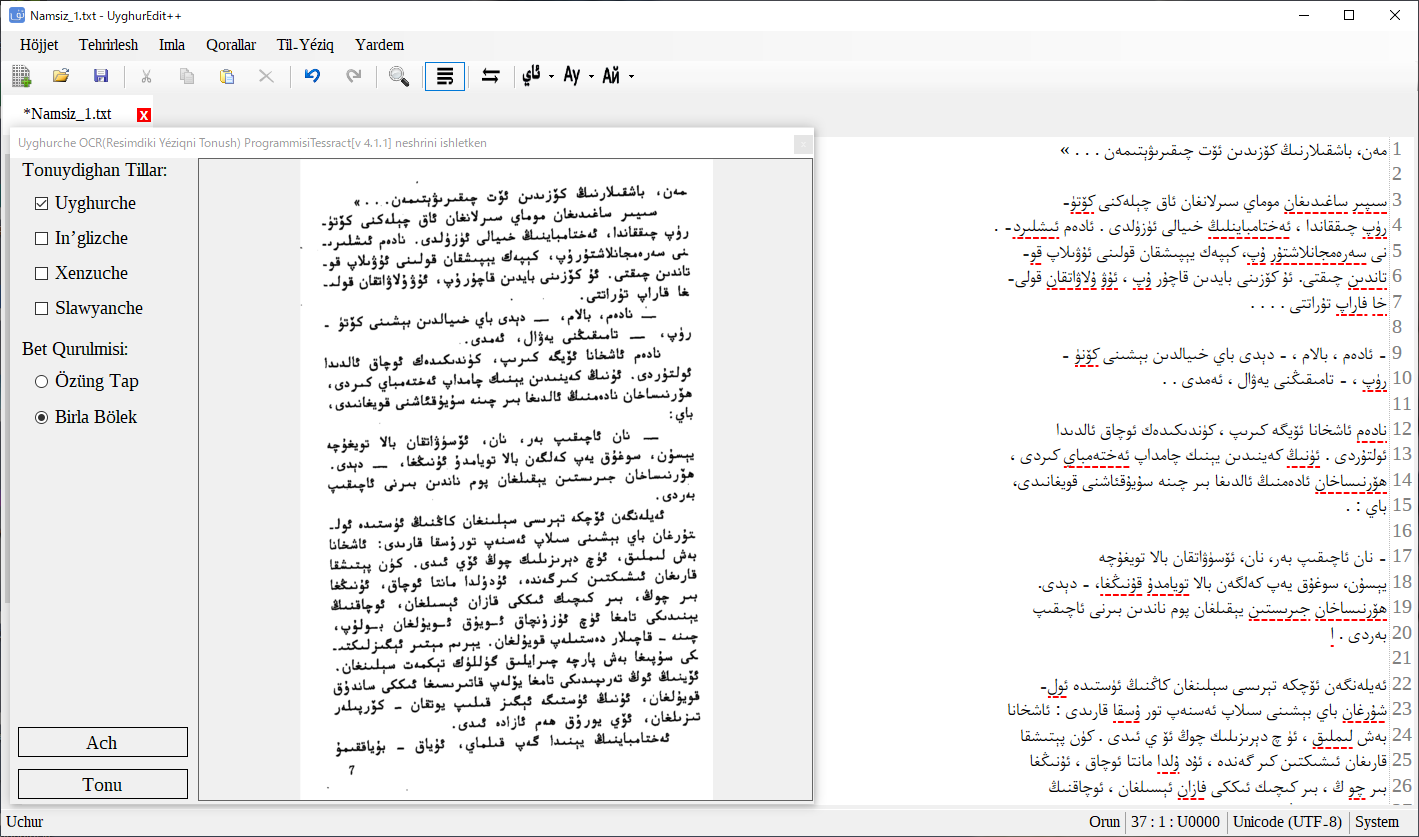
スペルチェック・文字の変換・OCR(画像の中の文字の読み取り)を備えた、ウイグル語を書くための無料のテキストエディタです。
主な機能
- スペルチェック:綴りの誤った語に赤い下線を引いて示し続けます。
- 文字の変換:アラビア文字・ラテン文字・キリル文字のあいだで書き換えます。
- OCR:画像の中の文字を読み取ってテキストにします。ウイグル語・英語・中国語・トルコ語に対応し、文字の混じった画像も読み取れます。
- クリップボードに画像があるときに貼り付けると、自動で OCR が始まります。
- スペルチェックの辞書は、2009年刊の正書法辞典『Hazirqi Zaman Uyghur Edebiy Tilining Imla Lughiti』の語幹を活用させて作られ、約44万1千語を収めています。
- ラテン文字入力モード(Ctrl+K で切り替え)。
- 編集中の文書から HTML を作成。
0.82 の変更点
- Tesseract のウイグル語モデルを学習し直し、認識の正確さが大きく上がりました。
- 編集中の文書を Word 形式(.docx)で保存できるようになりました(「Qorallar」メニュー)。
- Word で書いたウイグル語の文書(.docx)を、元のページ構成を保ったまま別の文字(アラビア文字・ラテン文字・キリル文字)に変換できるようになりました(「Qorallar」メニュー)。
画面
ライセンスとソースコード
UyghurEdit++ はオープンソースのソフトウェアで、MIT ライセンスで公開されています。ソースコードを取得して自分でビルドして使うこともできます。
このページの画面写真とアイコンは、同じリポジトリのものを MIT ライセンスのもとで掲載しています。